
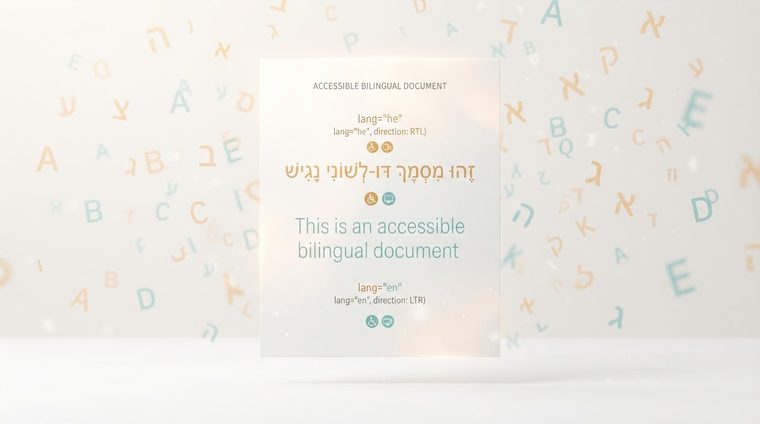
Представьте, что программа чтения с экрана пытается прочитать вслух предложение на иврите, но «думает», что текст написан на английском языке. Результат: буквы звучат наоборот, слова неправильно соединяются и целое предложение становится непонятным, хотя сам текст написан совершенно правильно. Причина: языковой тег документа отсутствует или неправильный. Это одна из наиболее распространенных проблем в двуязычных или многоязычных документах, а также одна из самых простых в устранении.
Короче — о чем идет речь в этом руководстве
Почему языковые теги влияют на направление чтения
Каждый доступный цифровой документ — HTML или PDF — нуждается в определенном языковом теге (например, he для иврита, en для английского языка). Этот тег не только помогает программе чтения с экрана выбрать правильный акцент и произношение — он также определяет направление чтения (RTL vs. LTR) текста. Если тег отсутствует, программное обеспечение для чтения может сделать неправильные предположения, и в некоторых случаях это приводит к тому, что буквы или слова читаются в обратном порядке, даже если визуальное отображение на экране выглядит совершенно нормально.
Как установить язык в Word
В Word язык документа по умолчанию установлен в разделе Просмотр ▸ Язык ▸ Установить язык проверки — там выбираем «Иврит» и отмечаем его как язык по умолчанию для документа. Важно: изменение только языка отображения самого программного обеспечения не приводит к изменению языкового тега, встроенного в документ. Вам необходимо убедиться, что этот параметр применяется к содержимому документа и что он сохраняется при экспорте в PDF.
Как установить язык в Acrobat
Даже если документ был правильно экспортирован из Word, стоит подтвердить его в Acrobat: Свойства документа ▸ Дополнительно ▸ Параметры чтения — здесь задается язык по умолчанию для всего документа. Для определенных отрывков текста на языке, отличном от общего языка документа (например, английской цитаты в документе на иврите), вы можете выбрать этот отрывок в дереве Теги, открыть Свойства тега и выбрать конкретный язык для этого сегмента на вкладке Тег.
Документы, содержащие иврит и английский язык
Во многих деловых документах иврит смешивается с английскими терминами, названиями продуктов или адресами электронной почты. В большинстве случаев алгоритм Unicode Bidi (который обрабатывает двунаправленный текст) правильно обрабатывает такие короткие сегменты внутри предложения на иврите, если общий язык документа установлен правильно. Проблема усугубляется, главным образом, с целыми абзацами в документе на другом языке — их стоит пометить отдельно, как описано выше, чтобы обеспечить правильное чтение как самого абзаца, так и того, что его окружает.
💡 Практический совет
Быстрая проверка: откройте свойства документа в Acrobat и проверьте поле языка. Если оно пустое или «Неизвестно» — это первое, что нужно исправить, перед любой другой проверкой доступности.
Не уверены, правильно ли установлен язык ваших документов?
Наш инструмент проверяет языковые теги в каждом PDF-файле на вашем сайте в рамках полного автоматического сканирования.
Сканируйте ваш сайт бесплатно ←